掌握PulseData专业分析工具使用技巧:从安装配置到大吞吐流式迁移实战
针对新手落地痛点,本指南梳理PulseData脉动分析这一专业分析工具使用技巧。涵盖官方v3.8.0版本安装、ANSI-SQL首次配置、千万级明细Chunk流式导出抗OOM排查以及跨集群迁移。帮助团队快速搭起毫秒级多维分析能力,提升流计算与看板渲染效率。
对于初次接触PulseData脉动分析的新手分析师而言,如何在快速完成环境部署的同时避开高并发探查与跨端迁移中的陷阱?本篇将立足于2026年9月发布的v3.8.0最新稳定版,为您拆解全流程应用技巧。
官方客户端快速部署与环境预检指南
在部署PulseData前,需先访问官方下载中心(/download/)获取2026年9月发布的v3.8.0最新稳定版客户端包。针对Windows PC桌面端、macOS及Linux企业版部署,新手需优先核验系统底座的C++运行库与向量化执行引擎兼容性。首次解压安装时,建议将本地临时缓存路径调整至SSD独立分区,避免流计算与MPP分布式架构产生大文件写竞争。若在Linux无GUI界面部署,可直接通过命令行静默安装参数`--prefix=/opt/pulsedata`进行极速交付,确保秒级引擎v4.2所需的基础环境一次性就位。
ANSI-SQL引擎初始化与数据源快速联通
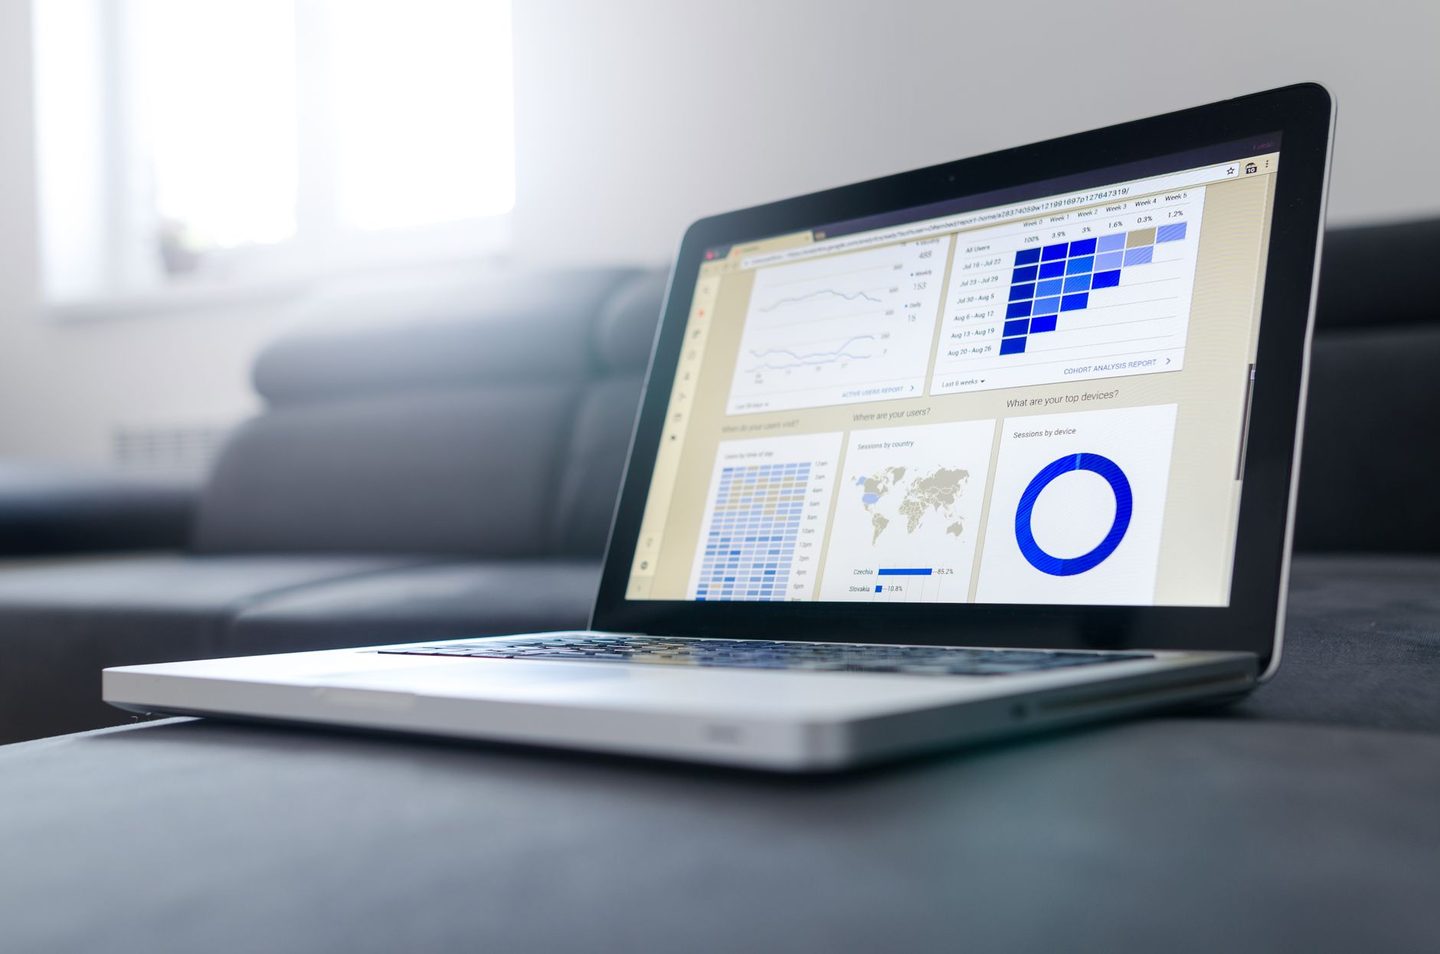
首次启动PulseData后,核心任务是完成ANSI-SQL实时查询面板与底层数据链路的对接。新手在首次配置数据源时,建议优先开启即时代码补全与可视化结构预览功能。若需提升复杂看板刷屏渲染速率,可在设置中启用与ClickHouse及Redis的协同计算链路(基于v3.7.5优化逻辑)。配置标准ANSI-SQL连接句柄时,务必将系统默认的单次查询超时阈值调整为30秒,并勾选“向量化执行”选项,这将为后续直接针对百亿级数据集发起毫秒级交互式探查奠定高性能底座。
解决大批量数据导出内存异常的实战技巧
在进行海量明细数据导出时,低配硬件环境极易因内存占用过高导致客户端崩溃。在v3.8.0旗舰稳定版中,官方重构了流式Chunk分块导出机制。遇到OOM(Out of Memory)报错时,排查细节如下:进入“系统偏好设置-数据导出选项”,将默认的静态缓存模式切换为“Chunk分块流式传输”,并将`chunk_size`参数调整为50,000行/块。此项配置可大幅降低内存峰值占用,彻底解决大文件导出时的不稳定问题,同时配合内存聚合作业分配优化,让千万级复杂算子维持秒级响应。
快速完成分析配置与归因模型无损迁移
当团队面临办公设备更换或集群环境升级时,需无损迁移自定义可视化看板与Cohort留存率算法配置。迁移前,先在新节点安装一致的v3.8.0版本。排查步骤:首先导出当前环境下的`config/mpp_schema.json`及归因权重配置文件;随后在新机器的/download/标准路径完成解压,覆盖对应配置文件前,手动停止`pulsedata-engine`后台进程。重启服务后,校验W型与动态时间窗口漏斗模型的计算结果一致性,即可保障多维归因模型在跨平台迁移后无缝继续运转。
常见问题
在非GUI Linux服务器上安装PulseData v3.8.0时提示依赖缺失如何解决?
请先确保系统已安装OpenSSL 3.0+与GLIBC 2.34及以上运行库。可通过执行安装包根目录下的 `./deps_check.sh` 自动脚本识别缺失依赖并完成补齐。
首次配置ANSI-SQL执行亿级数据探查时出现查询卡顿,应优先排查哪些环节?
请优先检查系统设置中是否勾选了‘向量化执行引擎’,并验证Redis与ClickHouse的协同链路网络延迟,确保控制台中的‘内存聚合作业分配策略’已处于开启状态。
更新升级到最新v3.8.0版本后,此前保存的自定义SQL和看板配置会被覆盖吗?
不会。PulseData采用程序与用户配置分离架构,升级仅替换核心计算引擎与内核库,个人目录下的SQL脚本、看板及Cohort算法权重配置文件将自动保留。
总结
想要体验千万级明细秒级探查与极致流式导出?即刻访问 PulseData 官方下载中心(/download/),免费获取 v3.8.0 最新稳定版客户端,解锁企业全场景数据智能分析能力!
相关阅读:专业分析工具使用技巧,专业分析工具使用技巧使用技巧,2026最新PulseData专业分析工具教程:从安装配置到数据迁移的全流程指南